7月20日,阿里巴巴旗下的通义千问正式发布了新一代语音合成大模型Qwen-Audio-3.0-TTS。该模型提供两个版本:一个是针对实时互动场景优化的Flash版,首包延迟时间仅需300毫秒;另一个是注重高品质音频输出的Plus版。
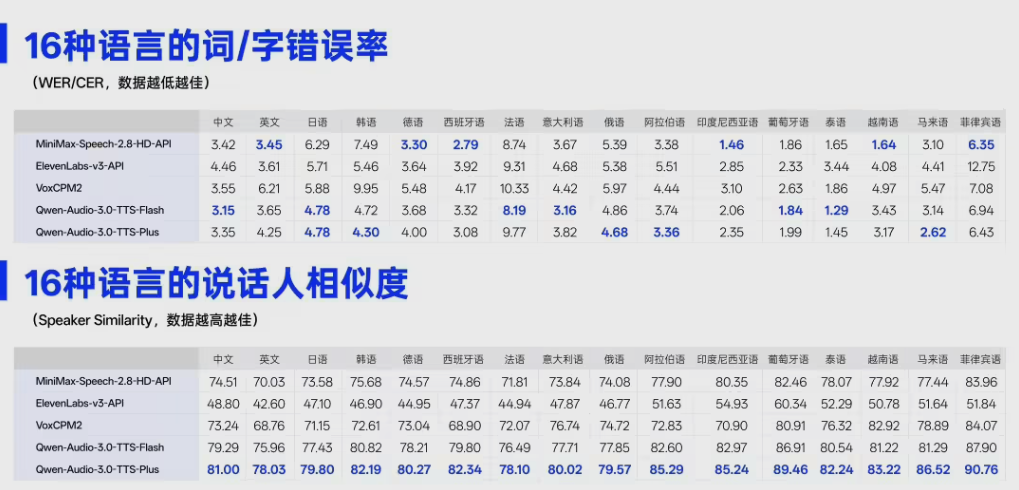
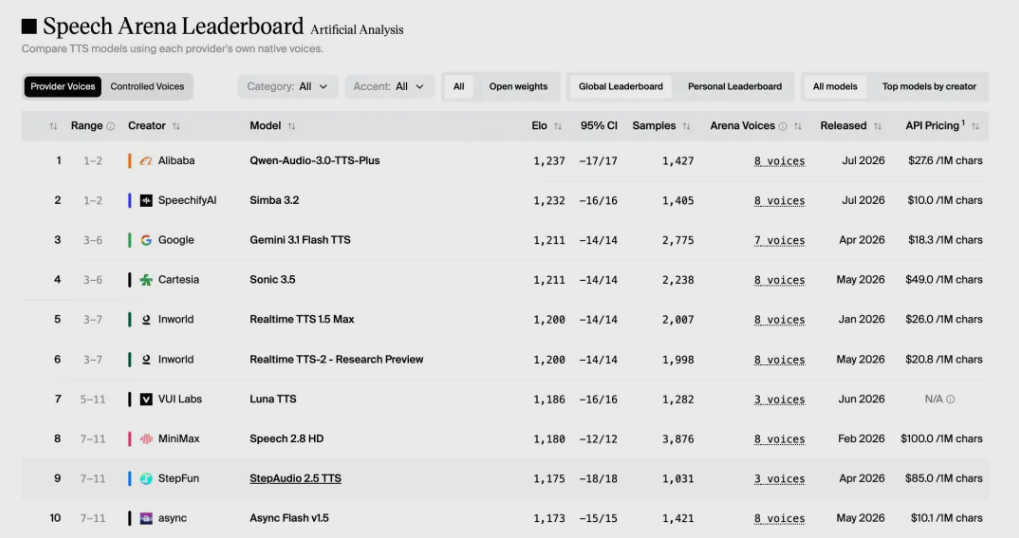
据官方介绍,新版模型在情感细腻度控制、风格化指令执行、多语言及方言支持、以及复杂声学环境适应性等方面均实现了显著提升,使得合成语音不再仅仅是简单的发声,而是能够传递出丰富的情感。在国际权威评测平台ArtificialAnalysis中,Qwen-Audio-3.0-TTS-Plus力压群雄,荣登综合排名榜首。
Qwen-Audio-3.0-TTS支持文本嵌入结构化标签,用户可以添加抽气、轻笑、愤怒等个性化标记,从而精确控制语音的情绪、语调和呼吸细节,实现更细腻的语音表达效果。
该模型还配备了现成的高质量音色库,将多语言、方言、指令控制等核心功能转化为可直接调用的资源。未来还将陆续推出风格化指令、20种方言、精细化控制以及14种以上小语种音色。此外,音频输出质量也由24KHz提升至48KHz,达到录音棚和影视配音的专业水准,单次合成时长可支持最长3分钟的连续语音。
在多语言适配方面,Qwen-Audio-3.0-TTS-Plus经过专门优化,共支持包括中、英、日、韩、德在内的16种语言,并新增了阿拉伯语、越南语、马来语和菲律宾语。同时,方言覆盖范围广泛,包括广东、重庆、东北、陕西、上海、四川、云南等20种主流方言。