7月20日消息,字节跳动正式发布了其音频创作模型Seed Audio 1.0。这一模型旨在满足全方位的音频创作需求,通过统一框架对多种音频元素进行整合建模,包括人声、音效和环境声等,能够实现从零开始到影视级水准的音频创作。
据官方介绍,声音已不仅仅是对画面的补充,而是能够直接参与故事叙述,在听众心中构建出画面,实现“听到即看到”的效果。该模型的核心功能包括:
多元素整合编排,支持精细的时间控制:只需一条提示词,即可生成带有情绪的对话、音效以及环境声,并能够沿着时间轴精确控制各种声音的出现时机。
音色和风格可控,长时间生成保持稳定:支持文本输入和参考音频导入,在长音频和多次续生成场景中保持角色音色的统一,同时同一音色也能演绎出不同的语气和情绪。
多语种自然生成:兼容20多种语言的音频制作,同一角色的语音能够适应不同语言的特点,展现自然的发音、节奏和表达方式。
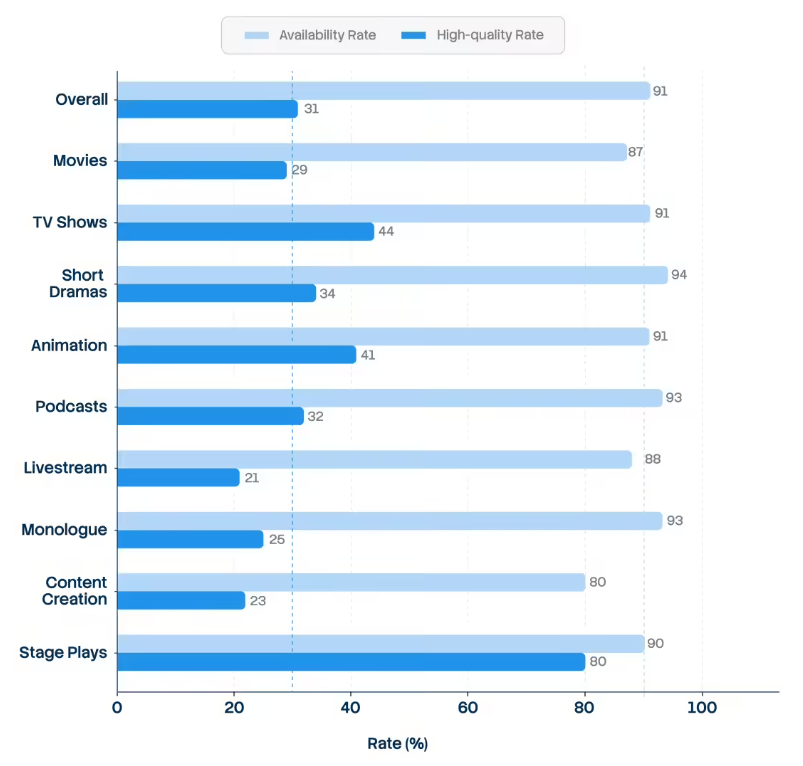
根据测试,在文本生成音色的相关评估中,Seed Audio 1.0在AB主观评测中表现突出,音频的可用率和优良率均有显著提升。
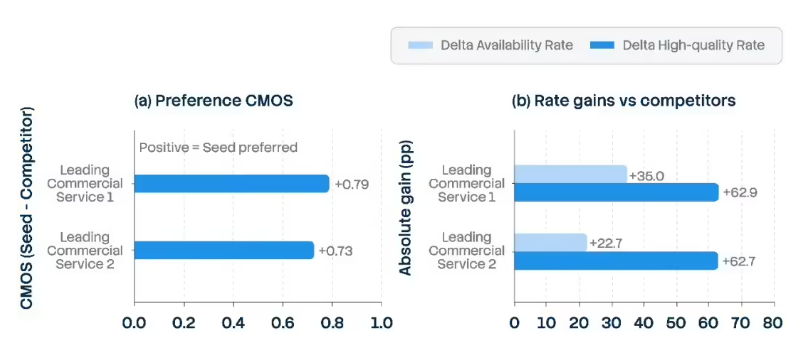
官方针对影视、短剧、动漫、播客对话、直播带货、网络创作、话剧、电视节目、语音合成等多个场景进行了音频生成能力测试。结果显示,该模型在大多数场景下的音频可用率超过90%。
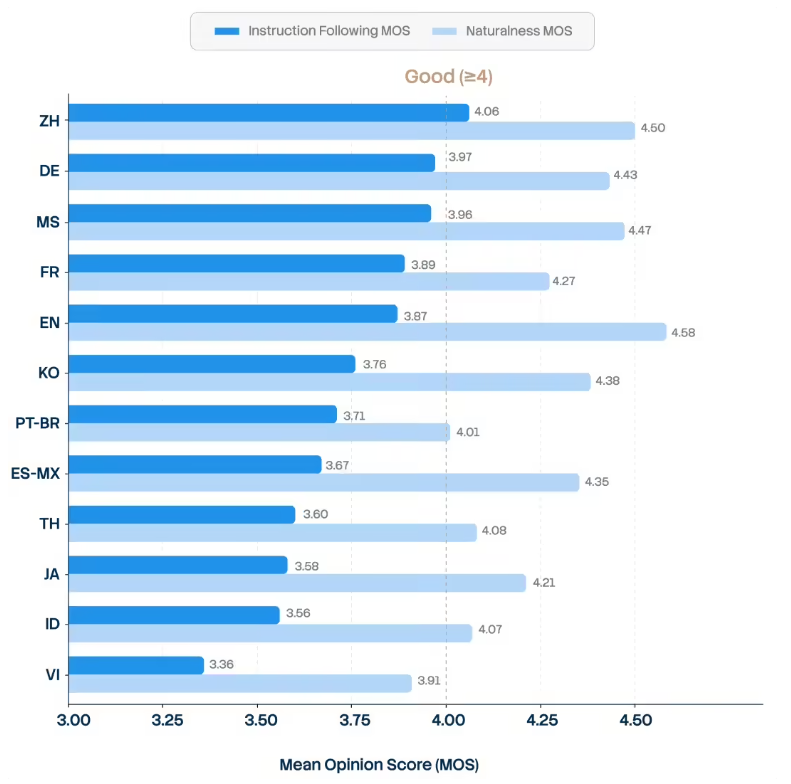
在多语言音频生成的表现方面,绝大多数语言的音频自然度MOS得分超过4分,音质表现出色;在复杂音频生成的指令遵从能力中,除越南语外,其他语言的MOS分数均高于3.5分,充分证明了Seed Audio 1.0在多语言指令理解方面的出色能力。